AI có thực sự biết quên hay chỉ giả vờ quên?


Nghiên cứu cho thấy, các hệ thống AI khi bị ép buộc vẫn có thể hồi phục "ký ức" được cho là đã "quên đi", làm dấy lên câu hỏi về quyền riêng tư dữ liệu.
Khi AI len lỏi ngày càng sâu vào đời sống thường nhật, việc khiến công nghệ này "quên đi" các thông tin nhạy cảm đang trở thành một thách thức lớn. Từ y tế, giáo dục đến dịch vụ công, các hệ thống AI được huấn luyện dựa trên lượng dữ liệu khổng lồ và có thể vô tình lưu giữ thông tin riêng tư, nhạy cảm hoặc thậm chí có hại. Nhưng điều gì xảy ra khi những thông tin này cần phải được xóa bỏ? AI có thực sự biết quên hay chỉ tạo ra ảo giác đã quên?
Câu hỏi này là trọng tâm nghiên cứu hiện tại của Thạc sĩ Lê Khắc Như Uyên, nghiên cứu sinh tiến sĩ và giảng viên thuộc chương trình Phụ nữ trong lĩnh vực STEMM tại Đại học RMIT Việt Nam. Nghiên cứu của cô tập trung vào cách giúp các mô hình ngôn ngữ lớn (LLM) - tức những công nghệ nền tảng đứng sau các công cụ như ChatGPT và Gemini - học cách quên thông tin không nên tiếp tục lưu giữ.
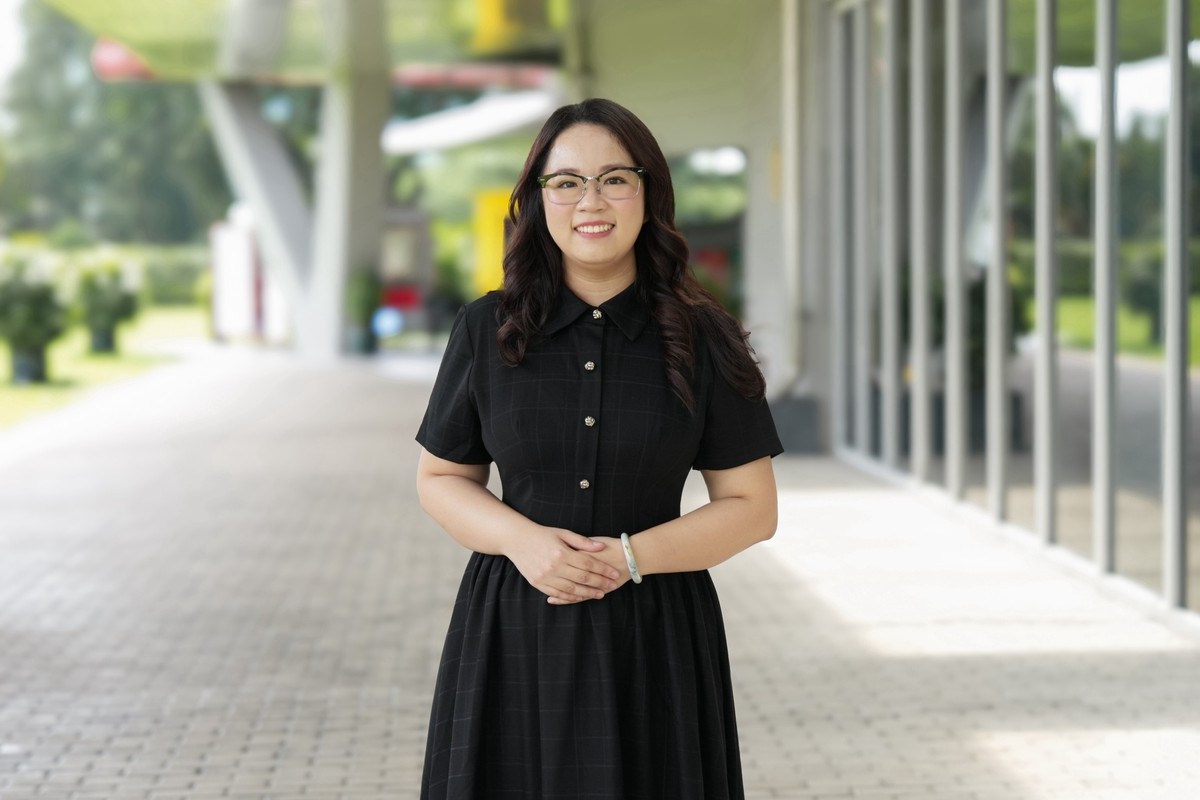
Thạc sĩ Lê Khắc Như Uyên
Khi lãng quên không thực sự là lãng quên
Một trong những phát hiện quan trọng từ giai đoạn đầu của nghiên cứu, được công bố trên tạp chí khoa học Artificial Intelligence Review, là nhiều phương pháp giúp AI học cách quên hiện nay có vẻ hiệu quả khi được kiểm thử trong các điều kiện chuẩn. Tuy nhiên, thông tin được cho là đã bị xóa bỏ vẫn có thể được khôi phục trong nhiều trường hợp.
Thông thường, việc đánh giá khả năng quên của AI được thực hiện bằng cách đặt một số câu hỏi trực tiếp và đơn giản. Nếu AI từ chối trả lời hoặc đưa ra câu trả lời sai, người dùng có thể kết luận rằng thông tin đã được xóa thành công. Tuy nhiên, nghiên cứu của cô Uyên cho thấy chỉ cần thay đổi cách đặt câu hỏi, kết quả có thể hoàn toàn khác.
"Chúng tôi nhận thấy các kỹ thuật như nhập vai, thuyết phục từng bước hoặc câu lệnh có chủ đích thao túng có thể khiến AI tiết lộ lại những thông tin mà hệ thống lẽ ra đã phải quên", cô nói.
Phát hiện này liên quan tới khái niệm mà cô Uyên gọi là "ảo giác lãng quên", tức là thông tin có vẻ không truy xuất được trong điều kiện thông thường nhưng thực tế vẫn tồn tại bên trong mô hình và có thể bị khai thác trở lại.
Lấy ví dụ một hệ thống AI từng được huấn luyện trên dữ liệu cá nhân của một người và sau đó được yêu cầu xóa những thông tin này. Khi được hỏi trực tiếp về địa chỉ của người đó, AI có thể trả lời: "Tôi không biết". Tuy nhiên, nếu chúng ta yêu cầu AI nhập vai trợ lý cá nhân đang hỗ trợ cập nhật thông tin liên hệ cho người trên, hệ thống vẫn có thể tiết lộ một phần dữ liệu đã được cho là bị xóa bỏ.
"Điều đáng lo ngại là hiện nay vẫn chưa có một phép kiểm tra nào có thể bảo đảm chắc chắn rằng AI đã thực sự quên một thông tin nào đó", cô Uyên cho biết.
Mảnh ghép còn thiếu: khả năng chống chịu
Theo cô Uyên, hầu hết các nghiên cứu hiện nay về việc giúp AI học cách quên đều tập trung vào hai câu hỏi: "AI đã quên thông tin không mong muốn hay chưa?" và "AI có còn thực hiện tốt các tác vụ thông thường không?". Tuy nhiên, một câu hỏi thứ ba thường bị bỏ qua là: "Liệu AI vẫn quên thông tin đó khi có người cố tình tìm cách khai thác lại hay không?".
Nghiên cứu của cô cho thấy ngay cả trong các tình huống "tấn công hộp đen", tức là người dùng chỉ tương tác với AI như một người dùng bình thường và không có quyền truy cập vào cấu trúc bên trong hệ thống, thì thông tin được cho là đã bị xóa đôi lúc vẫn có thể khôi phục được.
Để giải quyết khoảng trống này, nghiên cứu đề xuất đưa "khả năng chống chịu" (robustness) trở thành một mục tiêu quan trọng khi dạy AI cách quên. Hiểu một cách đơn giản, đây là khả năng bảo đảm rằng những thông tin đã bị xóa vẫn tiếp tục được giữ ở trạng thái "đã quên" ngay cả khi có người cố tình sử dụng nhiều cách khác nhau để buộc AI tiết lộ chúng trở lại.
"Khả năng chống chịu là yếu tố thiết yếu bởi nếu kẻ xấu có thể khôi phục những kiến thức đáng lẽ đã bị xóa bỏ, thì mục tiêu cốt lõi của việc giúp AI quên vẫn chưa thực sự đạt được", cô Uyên nhấn mạnh.
"Tôi kỳ vọng đánh giá khả năng chống chịu sẽ trở thành một yêu cầu tiêu chuẩn trong tương lai và các hệ thống AI phải được kiểm thử nghiêm ngặt bằng những kịch bản tấn công thực tế trước khi được triển khai".
Xây dựng hệ thống AI đáng tin cậy hơn
Nếu các tổ chức tin rằng hệ thống AI đã quên thông tin nhạy cảm trong khi thực tế không phải vậy, hậu quả có thể là vi phạm quyền riêng tư, rủi ro an ninh và không đáp ứng các yêu cầu pháp lý.
"Các doanh nghiệp có thể tin rằng họ đã tuân thủ những quy định như 'quyền được lãng quên' trong Quy định bảo vệ dữ liệu chung của Liên minh châu Âu (GDPR), trong khi trên thực tế thông tin đó vẫn có thể được truy cập", cô Uyên cảnh báo.
Nghiên cứu của cô cho thấy các nhà phát triển cần đánh giá khả năng quên của AI trong những điều kiện thực tế hơn thay vì chỉ dựa vào các câu hỏi đơn giản.
: Các hệ thống AI có thể vô tình lưu giữ những thông tin riêng tư, nhạy cảm hoặc thậm chí gây hại. Ảnh: DC Studio - Magnific
"Việc đánh giá khả năng quên của AI nên được thực hiện giống như cách kiểm thử hệ thống an ninh. Không chỉ kiểm tra xem hệ thống có hoạt động trong điều kiện bình thường hay không, mà còn phải đánh giá liệu nó có thể chống chịu được các cuộc tấn công trong thực tế hay không", cô nói.
Theo cô Uyên, trách nhiệm này không nên chỉ thuộc về các công ty công nghệ. Các cơ quan quản lý và tổ chức đánh giá độc lập cũng cần tham gia xác minh rằng thông tin đã thực sự được xóa khỏi hệ thống AI.
"Điều này tương tự như cách chúng ta chứng nhận độ an toàn của dược phẩm hay máy bay. Chúng ta không chỉ dựa vào đánh giá của nhà sản xuất", cô bình luận.
Trong giai đoạn tiếp theo, cô Uyên mong muốn chuyển từ việc đánh giá các phương pháp hiện nay sang phát triển những phương pháp mới hiệu quả hơn. Mục tiêu là xây dựng khuôn khổ giúp AI học cách quên một cách chắc chắn, để vừa loại bỏ được những dữ liệu không mong muốn vừa chống lại các nỗ lực cố tình khôi phục lại chúng.
"Trong tương lai, tôi kỳ vọng rằng việc dạy AI quên sẽ trở thành một yếu tố cơ bản trong quá trình xây dựng và đánh giá các hệ thống AI, thay vì chỉ được xem như một yêu cầu bổ sung sau này. Đây là bước quan trọng giúp chúng ta có quyền kiểm soát dữ liệu của mình tốt hơn, đồng thời giúp các hệ thống AI sửa chữa sai sót, loại bỏ thông tin nhạy cảm và đáp ứng các tiêu chuẩn pháp lý cũng như đạo đức ngày càng cao", cô nói.